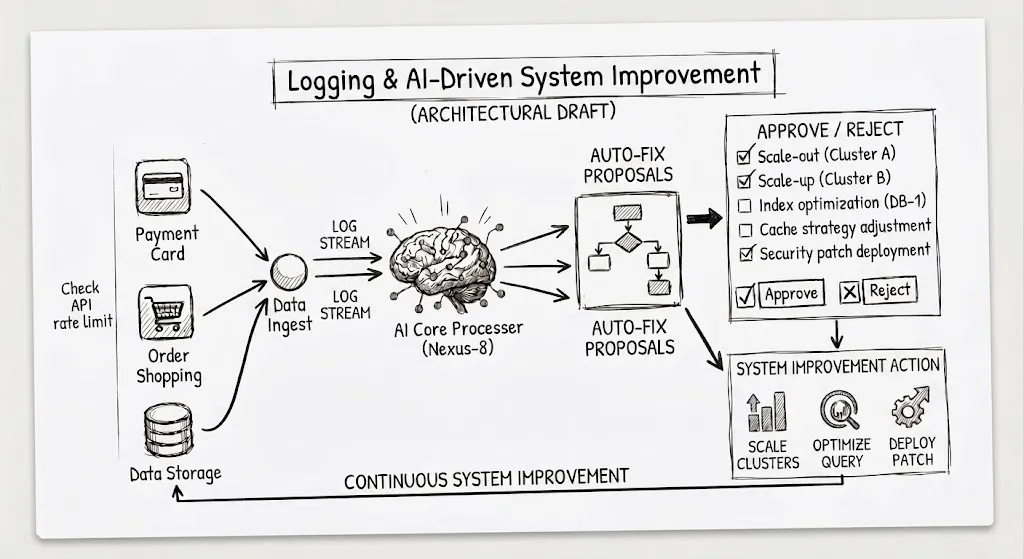
Logging là một trong những thành phần cơ bản nhất của một hệ thống phần mềm.
Khi một hệ thống gặp lỗi, việc đầu tiên developer thường làm là mở logs và tìm xem chuyện gì đã xảy ra.
- Một request bị lỗi ở đâu?
- Service nào gây ra lỗi?
- Lỗi bắt đầu từ khi nào?
- Có bao nhiêu request bị ảnh hưởng?
- Đây là một lỗi mới hay đã từng xảy ra trước đó?
Tất cả những câu hỏi này đều cần thông tin từ hệ thống logging và observability. Nhưng cách chúng ta xây dựng software đang thay đổi.
AI ngày nay không chỉ có thể viết code. AI có thể đọc codebase, phân tích logs, tìm nguyên nhân của một incident, tạo pull request và đề xuất cách cải thiện hệ thống.
Điều này dẫn đến một câu hỏi thú vị:
Nếu AI cũng cần sử dụng logs để hiểu và cải thiện hệ thống, chúng ta nên xây dựng logging system như thế nào?
Câu trả lời không phải là collect càng nhiều logs càng tốt.
Vấn đề quan trọng hơn là:
Làm thế nào để cung cấp cho AI đủ thông tin, đúng thông tin và đủ context để AI có thể hiểu chuyện gì đang xảy ra trong hệ thống?
Những điều cơ bản của một Logging System
Trước khi nói về AI, chúng ta cần một nền tảng logging đủ tốt.
Một logging system cơ bản không nhất thiết phải phức tạp. Về bản chất, nó cần giúp chúng ta trả lời một số câu hỏi:
- Chuyện gì đã xảy ra?
- Xảy ra khi nào?
- Xảy ra ở đâu?
- Request hoặc operation nào liên quan?
- Mức độ nghiêm trọng như thế nào?
- Nó có liên quan đến component hay service nào khác không?
Log những gì cần thiết
Không phải mọi dòng code đều cần một log.
Một log tốt nên chứa thông tin có ích để hiểu hành vi của hệ thống.
Ví dụ:
{
  "level": "ERROR",
  "event": "payment_failed",
  "service": "payment-service",
  "operation": "create_payment",
  "error_type": "TimeoutError"
}
Nhìn vào log này, chúng ta biết payment đã thất bại, service nào liên quan và loại lỗi là gì.
Mục tiêu của logging không phải là tạo ra thật nhiều dữ liệu.
Mục tiêu là tạo ra đúng dữ liệu.
Structured Logging
Một logging system tốt nên sử dụng structured logs thay vì chỉ ghi text tự do.
Ví dụ:
Payment failed for user 123khó search và khó phân tích hơn:
{
  "event": "payment_failed",
  "user_id": "123",
  "payment_id": "456",
  "error_type": "TimeoutError"
}
Khi logs có cấu trúc rõ ràng, chúng ta có thể dễ dàng:
- search
- filter
- aggregate
- correlate
- phân tích bằng code
- phân tích bằng AI
Điều này càng trở nên quan trọng khi hệ thống ngày càng lớn.
Context quan trọng hơn số lượng Logs
Một log đơn giản như:
ERROR: Request failedgần như không giúp được nhiều.
Chúng ta cần thêm context:
{
  "timestamp": "2026-09-04T10:00:00Z",
  "level": "ERROR",
  "service": "payment-service",
  "environment": "production",
  "request_id": "req_123",
  "trace_id": "trace_456",
  "operation": "create_payment",
  "error_type": "TimeoutError",
  "dependency": "stripe",
  "duration_ms": 10234
}
Bây giờ chúng ta biết:
- service nào gặp lỗi
- môi trường nào
- request nào
- operation nào
- dependency nào
- loại lỗi gì
- request mất bao lâu
Đây mới là information có giá trị để điều tra.
Correlation
Trong một hệ thống distributed, một request có thể đi qua rất nhiều service:
API Gateway
     ↓
Order Service
     ↓
Payment Service
     ↓
Database
     ↓
External API
Nếu mỗi service tạo ra logs độc lập, việc tìm nguyên nhân sẽ rất khó.
Vì vậy chúng ta cần những thông tin như request_id và trace_id để kết nối các
events với nhau.
Khi đó chúng ta có thể nhìn thấy:
trace_id = abc123

API Gateway
    ↓
Order Service
    ↓
Payment Service
    ↓
Stripe API
    ↓
Timeout
Thay vì nhìn thấy năm logs riêng biệt, chúng ta nhìn thấy một request flow hoàn chỉnh.
Logs không phải là tất cả
Logs chỉ là một phần của observability. Thông thường chúng ta có ba loại dữ liệu, mỗi loại trả lời một câu hỏi khác nhau:
| Loại | Trả lời câu hỏi | Cùng một sự cố sẽ thấy gì |
|---|---|---|
| Logs | Chuyện gì đã xảy ra? | Payment request thường xuyên timeout |
| Metrics | Xảy ra bao nhiêu lần, có nghiêm trọng không? | Error rate tăng từ 0.2% → 8% |
| Traces | Xảy ra ở đâu trong request flow? | Phần lớn latency đến từ external payment API |
Khi kết hợp cả ba, chúng ta có một bức tranh đầy đủ hơn về hệ thống.
Một Logging System “đủ tốt” là gì?
Có thể tóm tắt một logging system tốt bằng vài nguyên tắc: đúng thông tin, đủ context, format nhất quán, correlate được, search và phân tích được, và reliable mà không tạo ra vấn đề về security hay cost.
Đây là nền tảng đủ tốt cho developer.
Nhưng nếu muốn AI sử dụng hệ thống này thì chúng ta cần đi xa hơn.
Khi AI trở thành một Consumer của Logs
Trong mô hình truyền thống:
System
   ↓
Logs
   ↓
Developer
   ↓
Investigation
   ↓
Fix
Developer là người đọc logs và thực hiện toàn bộ quá trình reasoning.
Trong một hệ thống có AI:
System
   ↓
Logs / Metrics / Traces
   ↓
AI
   ↓
Investigation
   ↓
Proposal
   ↓
Developer Review
   ↓
Fix
AI trở thành một consumer khác của observability data.
Và điều này thay đổi cách chúng ta nên suy nghĩ về logging.
AI không cần nhiều Logs. AI cần đủ Context.
Đây có lẽ là điểm quan trọng nhất.
Khi một incident xảy ra, chúng ta có thể có hàng triệu logs.
Nhưng nếu các logs đó không có context, AI vẫn không thể hiểu chuyện gì đang xảy ra.
Ví dụ:
ERROR: Request failedAI không biết:
- Request nào?
- Service nào?
- User nào?
- Operation nào?
- Dependency nào?
- Có bao nhiêu request bị ảnh hưởng?
- Lỗi bắt đầu từ khi nào?
- Có deployment nào vừa xảy ra không?
Ngược lại, nếu logs có đầy đủ context, AI có thể bắt đầu reconstruct lại incident.
Ví dụ:
10:01:02
request started
request_id=req_123

10:01:03
order created
service=order-service

10:01:04
payment started
service=payment-service

10:01:14
payment timeout
dependency=stripe
duration=10s

10:01:15
request failed
AI có thể nhìn thấy một sequence:
Request
  ↓
Create Order
  ↓
Create Payment
  ↓
Stripe timeout
  ↓
Request failed
Đây là khác biệt giữa logs collection và system understanding.
AI cần tính nhất quán
Một vấn đề khác là consistency.
Nếu mỗi service sử dụng một cách đặt tên khác nhau:
payment_timeout
stripe_timeout
external_timeout
payment_provider_error
AI sẽ phải đoán xem chúng có phải cùng một loại vấn đề hay không.
Thay vào đó, chúng ta có thể chuẩn hóa:
error_type = DEPENDENCY_TIMEOUT
dependency = stripe
service = payment-service
Khi đó AI dễ dàng nhận ra:
Có nhiều
DEPENDENCY_TIMEOUTliên quan đếnstripe.
Và từ đó có thể bắt đầu tìm pattern.
Điều này cho thấy:
AI-ready logging không chỉ cần structured logs. Nó cần semantic consistency.
Tên field, event, error type và cách biểu diễn dữ liệu nên có một contract rõ ràng.
Observability như một Contract
Ở đây logging bắt đầu có một vai trò mới.
Trước đây, logging thường được xem là implementation detail của application.
Nhưng nếu AI phụ thuộc vào logs để hiểu hệ thống, logs trở thành một interface giữa system và AI.
Application
      ↓
Observability Contract
      ↓
Logs / Metrics / Traces
      ↓
AI
Contract này có thể quy định một bộ field chung: service, environment,
request_id, trace_id, operation, event, error_type, dependency,
duration, status.
Không nhất thiết mọi service phải log chính xác cùng một bộ fields.
Nhưng những thông tin quan trọng nên có một cách biểu diễn nhất quán.
Điều này giúp AI không phải học lại cách hiểu logs của từng service.
AI cần Historical Context
Một log hiện tại đôi khi không đủ để tìm root cause.
AI cần khả năng nhìn lại lịch sử.
Ví dụ, error rate của cùng một endpoint: tháng trước 0.2%, hôm qua 0.3%, hôm nay 8%.
AI có thể bắt đầu tìm:
- Khi nào vấn đề bắt đầu?
- Có deployment nào xảy ra trước đó?
- Có configuration nào thay đổi?
- Đây có phải vấn đề đã từng xảy ra?
- Lần trước chúng ta đã giải quyết như thế nào?
Khi đó logs không chỉ là:
“Record of what happened.”
Nó trở thành một phần của system knowledge.
AI nên được phép làm gì?
Một AI system có access vào observability data có thể hỗ trợ nhiều bước trong engineering workflow:
| Bước | AI làm gì | Ví dụ |
|---|---|---|
| 1. Detect | Phát hiện bất thường | Error rate tăng đột ngột |
| 2. Investigate | Khoanh vùng | Các errors liên quan đếnpayment-service |
| 3. Correlate | Nối các mảnh lại | Error → Request → Trace → Deployment → Dependency |
| 4. Identify | Đưa ra hypothesis | Stripe API latency tăng sau deployment X |
| 5. Propose | Đề xuất hướng sửa | Tăng timeout, retry có exponential backoff, circuit breaker |
| 6. Implement | Tạo code change hoặc pull request | |
| 7. Verify | Quan sát lại sau deploy | Timeout rate 8% → 1% |
AI không chỉ tìm lỗi. Nó còn theo dõi được giải pháp có thực sự cải thiện hệ thống hay không.
Nhưng AI không nên là người quyết định cuối cùng
Đây là phần rất quan trọng.
Mục tiêu không phải:
AI đọc logs → AI tự sửa production.
Một mô hình thực tế và an toàn hơn là:
              System
                 ↓
       Logs / Metrics / Traces
                 ↓
                AI
                 ↓
       Analyze / Investigate
                 ↓
        Propose a solution
                 ↓
            Developer
              Review
                 ↓
          Approve / Reject
                 ↓
              Deploy
AI chịu trách nhiệm cho phần reasoning và execution support.
Developer vẫn chịu trách nhiệm cho judgment.
Developer có thể xem:
- AI đã tìm thấy evidence gì?
- AI đang đưa ra hypothesis nào?
- Những logs nào support hypothesis đó?
- Thay đổi nào được đề xuất?
- Risk của thay đổi là gì?
Sau đó developer quyết định:
Approve hoặc Reject.
Đây là một mô hình human-in-the-loop.
Từ Incident Response đến Continuous Improvement
Điều thú vị nhất xảy ra khi chúng ta không chỉ dùng AI để xử lý incident.
Chúng ta có thể dùng cùng hệ thống để liên tục cải thiện hệ thống.
Ví dụ logs cho thấy 30% payment requests phải retry. AI điều tra và phát hiện:
External API
      ↓
Intermittent timeout
      ↓
Retry
      ↓
High latency
      ↓
More timeout
AI đề xuất: exponential backoff, circuit breaker, và cấu hình timeout hợp lý hơn.
Developer review và approve. Sau deployment, retry rate giảm từ 30% xuống 3%.
Bây giờ observability system tạo ra một feedback loop:
System
   ↓
Observe
   ↓
AI analyzes
   ↓
AI proposes improvement
   ↓
Developer reviews
   ↓
Change
   ↓
Deploy
   ↓
Observe again
   ↓
AI analyzes again
Đây không còn đơn thuần là logging.
Đây là một engineering feedback loop.
Logging trong AI-Native Engineering
Nếu nhìn rộng hơn, logging chỉ là một phần của một hệ thống lớn hơn.
             Running System
                    ↓
       ┌────────────┴────────────┐
       ↓                         ↓
     Code                  Observability
                                 ↓
                    Logs / Metrics / Traces
                                 ↓
                                AI
                                 ↓
                    Analyze / Investigate
                                 ↓
                         Proposed Change
                                 ↓
                           Developer
                             Review
                                 ↓
                             Deploy
                                 ↓
                         Running System
Trong mô hình này, observability không chỉ giúp chúng ta biết hệ thống đang làm gì.
Nó giúp AI hiểu hệ thống đang làm gì.
Và khi AI hiểu được hệ thống đủ tốt, nó có thể bắt đầu tham gia vào quá trình cải thiện hệ thống.
Kết luận
Một logging system tốt không phải là logging system có nhiều logs nhất.
Nó là logging system cung cấp:
- đúng thông tin
- đủ context
- format nhất quán
- khả năng correlate
- historical information
- và dữ liệu đủ đáng tin cậy để phân tích
Đối với developer, điều này giúp việc debugging trở nên dễ dàng hơn.
Nhưng trong AI-native engineering, chúng ta cần đặt thêm một câu hỏi:
Liệu AI có thể hiểu được hệ thống từ những thông tin mà chúng ta đang thu thập hay không?
Nếu câu trả lời là không, việc collect thêm logs chưa chắc giải quyết được vấn đề.
Chúng ta cần thiết kế observability data như một contract giữa system và AI.
Khi đó, AI có thể:
Detect
  ↓
Investigate
  ↓
Understand
  ↓
Propose
  ↓
Implement
  ↓
Verify
Trong khi developer vẫn giữ vai trò:
Review
  ↓
Validate
  ↓
Decide
Cuối cùng, mục tiêu không phải là xây dựng một hệ thống để AI tự động sửa mọi thứ.
Mục tiêu là xây dựng một hệ thống mà:
AI có đủ thông tin để hiểu vấn đề, đủ context để đưa ra một giải pháp tốt, và developer có đủ evidence để quyết định có nên thực hiện giải pháp đó hay không.
Khi đạt được điều này, logging không còn chỉ là một công cụ để debug.
Nó trở thành một phần của vòng lặp:
System → Observability → AI → Developer → System
Và đây là một trong những nền tảng quan trọng của AI-Native Engineering.